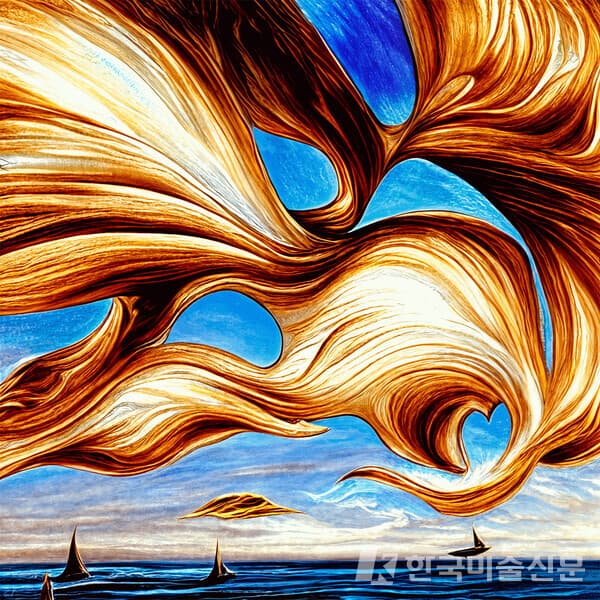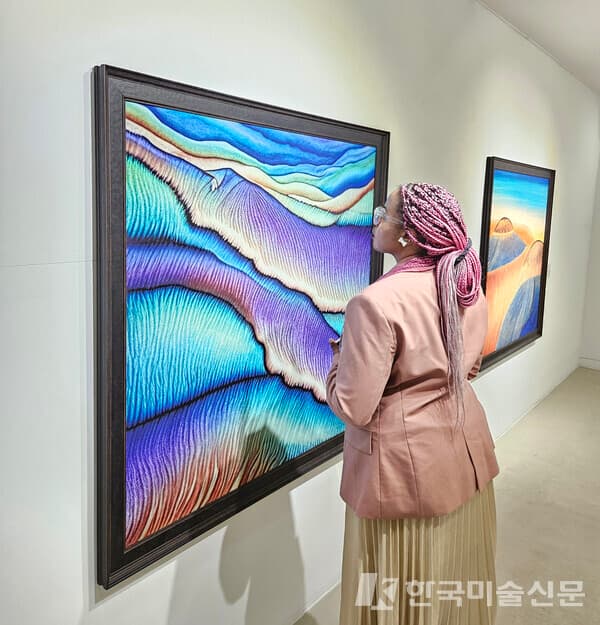
![Obvious In the Shadow of a Tsunami, 2024 Two-layer Digigraphie® print on cotton texture paper, Framed: 127 x 127 cm Unframed: 115 x 115 cm, signed with GAN model loss function in ink (사진=선화랑]](/_next/image?url=https%3A%2F%2Fimg.kmisul.com%2Flegacy%2F202504%2F4634_13205_376.jpg&w=3840&q=75)
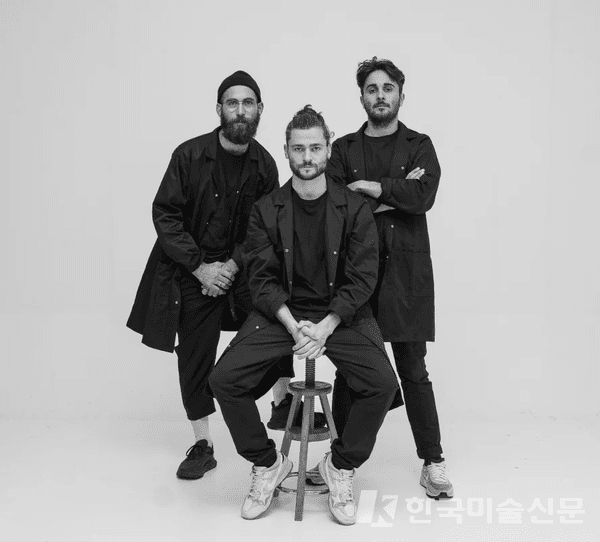
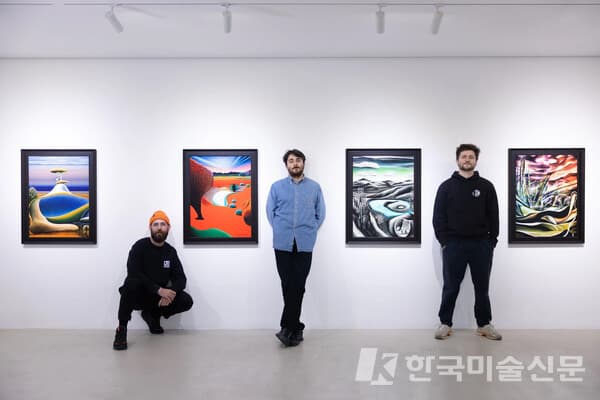
2018년 크리스티(Christie's) 경매에서 AI 생성 초상화 '에드몽 드 벨라미(Edmond de Belamy)'로 세계 미술계의 주목을 받은 프랑스 아티스트 그룹 OBVIOUS. Hugo Caselles-Dupré, Pierre Fautrel, Gauthier Vernier 세 명으로 구성된 이들이 한국에서의 첫 개인전 'Imagine'을 위해 서울을 찾았다.
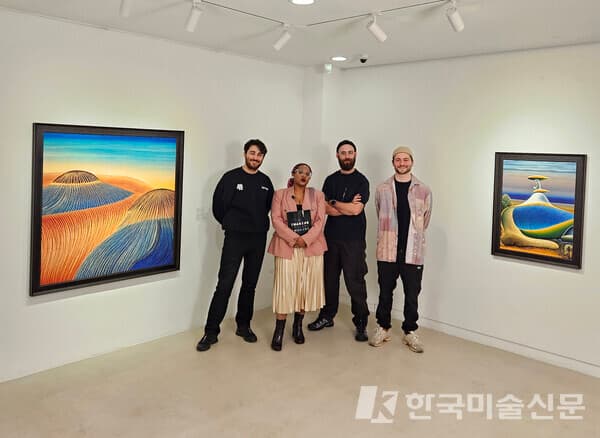
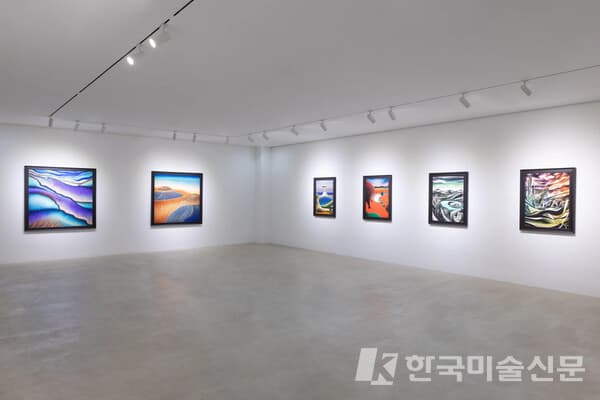
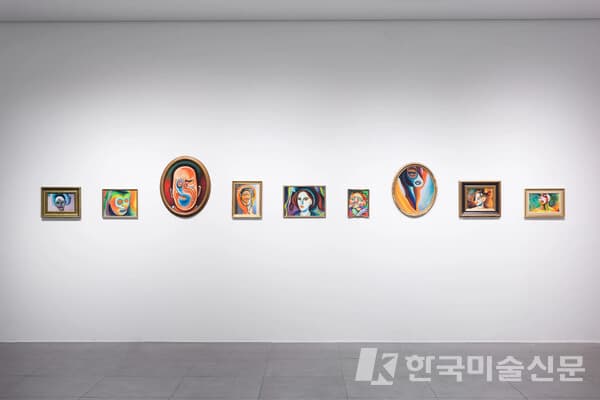
3월 8일부터 5월 3일까지 선화랑(Sun Gallery, 서울시 종로구 인사동 5길 8 (인사동184))에서 열리는 이번 전시는 AI를 통한 예술적 상상력의 확장 가능성을 탐구하며, Obvious의 최신 작업 시리즈를 포함한 다양한 작품들을 선보인다.
그들의 일주일 간 방한일정 중 선화랑에서 진행된 이번 인터뷰에서 AI와의 협업 과정, 예술적 철학, 그리고 한국에서의 첫 개인전 'Imagine'에 대한 그들의 생각을 직접 들어보았다.
이번 인터뷰는 한국에서 활동 중인 방송인 엘로디(Elody)가 진행을 맡았으며, 한국 영화와 드라마, 예능 프로 등 한국의 방송 콘텐츠를 프랑스OTT 플랫폼에 배급하며, 한국과 관련된 자체 콘텐츠도 제작하는 KFTV에서 영상촬영을 담당하였다.
(주) 본 인터뷰는 1시간 이상 AI 아트와 기술 및 예술 전반에 대한 심층적인 내용을 다루다 보니 상당히 방대한 분량의 질문과 답변으로 이루어졌다. 독자의 이해를 쉽게 하기 위하여 인터뷰 내용을 바탕으로 일부 질문과 답변은 그 내용을 정리하여 재작성 되었음을 알린다. 또한 필자도 인터뷰내용에 맞춰서 인터뷰 영상 내용을 요약 정리하는 과정에서 구글의 Gemini 도움을 받았음을 밝힌다.
Q: Obvious 멤버 여러분, 서울 선화랑에서의 첫 한국 개인전 'Imagine' 개최를 진심으로 축하드립니다. 그룹으로서는 첫 한국 방문이자 개인전인데, 소감이 어떠신가요?
A: (Obvious - Pierre Fautrel) 감사합니다. 저희 'Obvious'의 이름으로 한국에서, 특히 유서 깊은 선화랑(Sun Gallery)에서 첫 개인전 'Imagine'을 열게 되어 매우 영광스럽고 기쁩니다. 개인적으로는 방문한 적이 있지만, 아티스트로서 한국을 찾는 것은 이번이 처음입니다.
(Obvious - Hugo Caselles-Dupré) 네, 서울은 전통과 현대, 예술과 기술이 역동적으로 공존하는 도시라는 느낌을 받았습니다. 이러한 멋진 도시에서 저희의 'Imagine' 전시를 선보일 수 있게 되어 정말 기대가 큽니다. 많은 분들이 저희 작업에 큰 관심을 보여주시고 적극적으로 지원해주셔서 깊은 인상을 받았습니다.
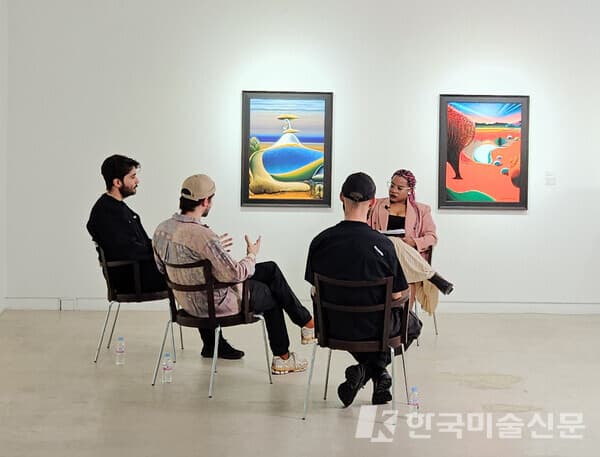
Q: 이번 전시 'Imagine' 은 인간의 무의식과 AI 기술의 결합을 마인드 투 이미지(Mind to Image)를 통해 초현실주의를 표현하고 있다고 설명하고 있습니다. 이 프로젝트를 어떻게 시작하게 되셨나요?
A: (Obvious - Gauthier Vernier) 이 프로젝트는 저희 연구실을 설립한 이후 처음으로 제작한 첫 번째 프로젝트이자 첫 번째 시리즈입니다. 이 프로젝트는 예술이 우리에게 무엇이고, 창작이 우리에게 무엇이냐는 비전을 세상에 제시하고자 하는 저희의 비전을 잘 보여준다고 생각합니다. 이 프로젝트에는 연구 요소가 포함되어 있으며, 저희는 이러한 예술 작품을 제작하기 위한 알고리즘을 개발하는 데 1년 넘게 시간을 투자했습니다.
그리고 이 알고리즘이 가능하게 한 창조의 한 부분이 있는데, 바로 기술 덕분에 가능해진 초현실주의적 창조입니다. 그래서 저희는 마인드 투 이미지(Mind to Image)라는 기술을 개발했습니다. 이 기술은 MRI에 자신을 넣고 이미지에 대해 생각한 후, 인공지능 알고리즘을 사용하여 이미지를 성공적으로 재구성하는 과정을 포함합니다. 이를 위해 저희는 신경과학자 및 창의성 전문가들과 함께 전체 프로세스를 개발했고, 인공지능 분야의 전문 지식을 적용했습니다. 그리고 이 모든 것의 결과가 오늘 서울에서 선보이는 작품들입니다.
이 전시는 저희의 생각에서 탄생한 예술 작품들로 구성되어 있습니다.
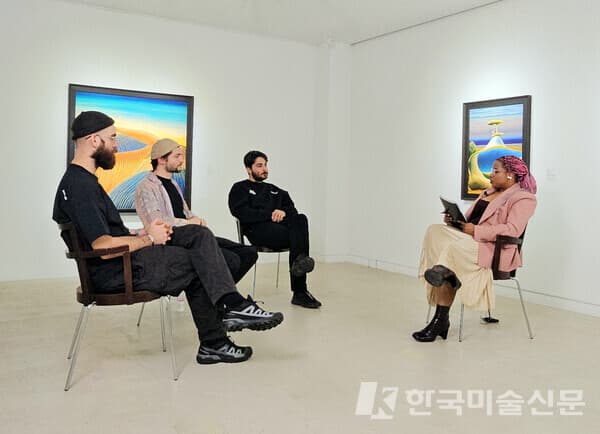
Q: 'Imagine' 전시에 대해 좀 더 구체적으로 소개해주실 수 있을까요? 어떤 주제와 작품들에 초점을 맞추셨나요? 그리고 이번 전시를 통해 관객들에게 어떤 관점을 제시하길 원하시나요?
A: (Obvious - Gauthier Vernier) 'Imagine' 전시는 관객이 전반적으로 초현실주의를 발견할 수 있도록 초대합니다. 초현실주의는 100년 전 파리에서 탄생한 운동입니다. 잠재의식의 세계와 잠재의식에서 작품, 즉 물리적인 창조물로 이동하는 가장 빠른 방법에 관심을 가진 과학자들이 있었습니다. 그래서 그들은 자동 글쓰기로 시작했습니다. 자동 글쓰기는 모든 필터를 제거하고, 깊이 생각하지 않고, 잠재의식이 스스로를 표현하도록 한 다음, 자신이 만들어낸 것을 읽는 것을 의미합니다. 이는 종종 매우 시적인 결과물을 만들어냅니다.
이것이 바로 저희 전시의 시작점입니다. 전시 초반에 바로 이러한 유형의 창조물을 중심으로 한 설치 작품이 있기 때문입니다. 그리고 이는 초현실주의 미학을 발견하고, 잠재의식의 세계와 사고의 세계에 접근하는 다양한 방식을 발견하도록 합니다. 이는 오늘날의 기술을 통해 이 운동을 재조명하는 방식이라고 할 수 있습니다. 만약 초현실주의자들이 우리 시대에 살았다면, 잠재의식에서 창조로 나아가기 위해 가능한 모든 도구를 사용했을 것이라고 생각합니다. 그래서 그들은 필연적으로 인공지능을 사용했을 것이고, 그것은 바로 의학 분야에서 활용이 가능합니다.
그래서 우리가 진정으로 하고 싶은 것은 바로 이것입니다. 오늘날의 도구, 즉 인공지능을 통해 초현실주의를 재발견하는 것입니다. 그리고 이번 전시를 통해 우리의 작품은 진정한 초현실주의 운동의 연속이지만, 훨씬 더 현실적인 요소와 이러한 대뇌 이미지를 번역하고 이런 종류의 예술 작품으로 변형시킬 수 있는 도구(Mind 2 Image)를 사용한 결과입니다.
우리는 초현실주의 사상의 연속성에 참여하려고 노력하고 있습니다. 그리고 초현실주의자들의 작품에서 많은 영감을 받았다고 생각합니다. 우리는 뭔가 근본적으로 다른 것을 하려고 하는 것이 아니며, 그것은 작품에서 분명하게 드러납니다. 왜냐하면 그 작품들은 초현실주의에 매우 가까운 미학을 갖고 있기 때문입니다. 또한 그 당시의 액자를 회상할 수 있는 형태로 제작된 물리적인 작품이기도 합니다. 그래서 저희는 연속성을 유지하려고 노력합니다. 그리고 그것이 바로 저희 작품만의 특징입니다.
우리가 가진 예술 형태는 디지털적인 관점을 확보하여 컴퓨터나 AI로 만들어졌다는 것을 분명히 보여주려는 파괴적인 예술 형태가 아닙니다. 오히려 대중이 자신이 아는 것과 연결될 수 있도록 하는 것입니다. 작품을 접할 때, 자신이 아는 것에서 인공지능에 접근할 수 있도록 말이죠. 이는 처음부터 비교를 가능하게 하는 일종의 수단입니다. 이를 통해서 우리의 작품을 이해할 수 있습니다.
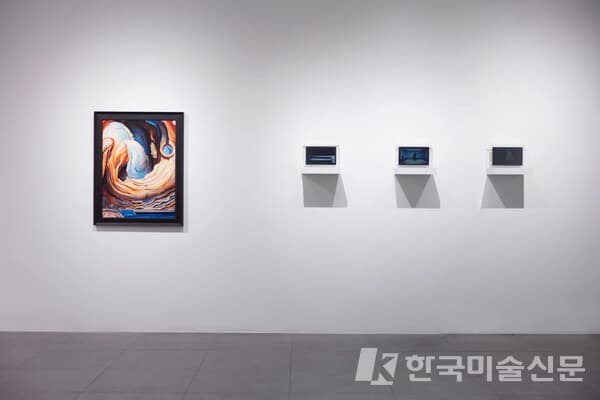
Q: 'Mind 2 Image'라는 작업 방식을 언급하셨는데, Obvious가 직접 개발하신 건가요? 기존의 프롬프트 기반 작업과는 어떻게 다른지, 그 과정을 좀 더 자세히 설명해주실 수 있나요?
A: (Obvious - Hugo Caselles-Dupré) 네, 'Mind 2 Image'는 저희가 AI와의 '대화(dialogue)'를 더욱 심화시키기 위해 최근 몇 년간 발전시켜온 작업 방식입니다. 기존의 텍스트 프롬프트(prompt)가 AI에게 구체적인 지시를 내리는 방식이었다면, 'Mind 2 Image'는 아티스트의 '정신적 이미지(mental image)' 또는 '개념(concept)' 자체를 보다 풍부하게 전달하는 데 초점을 맞춥니다.
첫 단계는 '개념 지도화(Conceptual Mapping)'입니다. 단순히 몇 줄의 텍스트가 아니라, 관련된 이미지 레퍼런스, 색상 팔레트, 감성적인 키워드, 심지어는 짧은 이야기나 시적인 문구까지 포함하는 복합적인 '개념 지도'를 만듭니다. 이는 아티스트의 머릿속에 있는 추상적인 아이디어를 최대한 다각적으로 표현하려는 시도입니다.
두 번째 단계는 '다중 AI 해석(Multi-Stage AI Interpretation)'입니다. 이 풍부한 개념 지도를 저희가 특별히 훈련시킨, 여러 AI 모델(GAN, Diffusion 등)이 결합된 시스템에 입력합니다. 시스템은 단순히 텍스트만 해석하는 것이 아니라, 이미지 간의 관계, 텍스트의 뉘앙스, 감성적 키워드 등을 종합적으로 이해하려고 시도하며 초기 시각적 결과물을 생성합니다.
마지막 단계는 '심층적 반복 수정(Deep Iterative Refinement)'입니다. AI가 내놓은 초기 결과물을 보면서, 저희는 단순히 프롬프트를 수정하는 것을 넘어, 개념 지도 자체를 업데이트하거나, 때로는 생성된 이미지의 특정 부분을 직접 조작하는 방식으로 피드백을 줍니다. 이 과정은 AI와 훨씬 더 긴밀하고 직관적인 '대화'를 가능하게 하며, 최종적으로 아티스트의 '마음(mind)' 속에 있던 이미지를 현실의 '이미지(image)'로 구현해내는 것을 목표로 합니다. 'Imagine' 전시에 포함된 신작들이 바로 이 과정을 통해 탄생했습니다.
![Obvious In the Shadow of a Tsunami, 2024 Two-layer Digigraphie® print on cotton texture paper, Framed: 127 x 127 cm Unframed: 115 x 115 cm, signed with GAN model loss function in ink (사진=선화랑]](/_next/image?url=https%3A%2F%2Fimg.kmisul.com%2Flegacy%2F202504%2F4634_13205_376.jpg&w=640&q=75)